把话题变成一条 完整的中文科普短视频。
explainer-video 是一个 Agent Skill:一套共用流程,两种画风——手绘白板与拟真竖屏出镜。事实核查过的稿子、逐字口播时间轴、配乐音效与混音母版、各平台文案,一次交付。
explainer-video 是什么?
explainer-video 是一个可复用的 Agent Skill——一个文件夹,里面是 SKILL.md 入口、一套共用制作流程、可直接运行的 Python/Shell 脚本,以及两种画风的完整渲染引擎。把整个文件夹放进 Agent 的 skills 目录,它就能端到端产出一条可发布的中文科普短视频:选题研究与事实核查、口语化写稿、配音转逐字时间轴、画面、配乐音效、质检过的母版,以及抖音 / 小红书 / B站 / 视频号 / X 的文案。
它不是文生视频模型。画面是真实代码——React/Remotion 合成与 Canvas 白板场景——由逐字时间轴驱动,所以每一帧都确定、可改、可重渲。换一版配音,动画、音效、字幕会自动重新对齐。
v2 时的名字是 handdrawn-explainer-video;v3 把白板与拟真合并成一个 skill,并加入了真人录音自动对齐。
两种画风
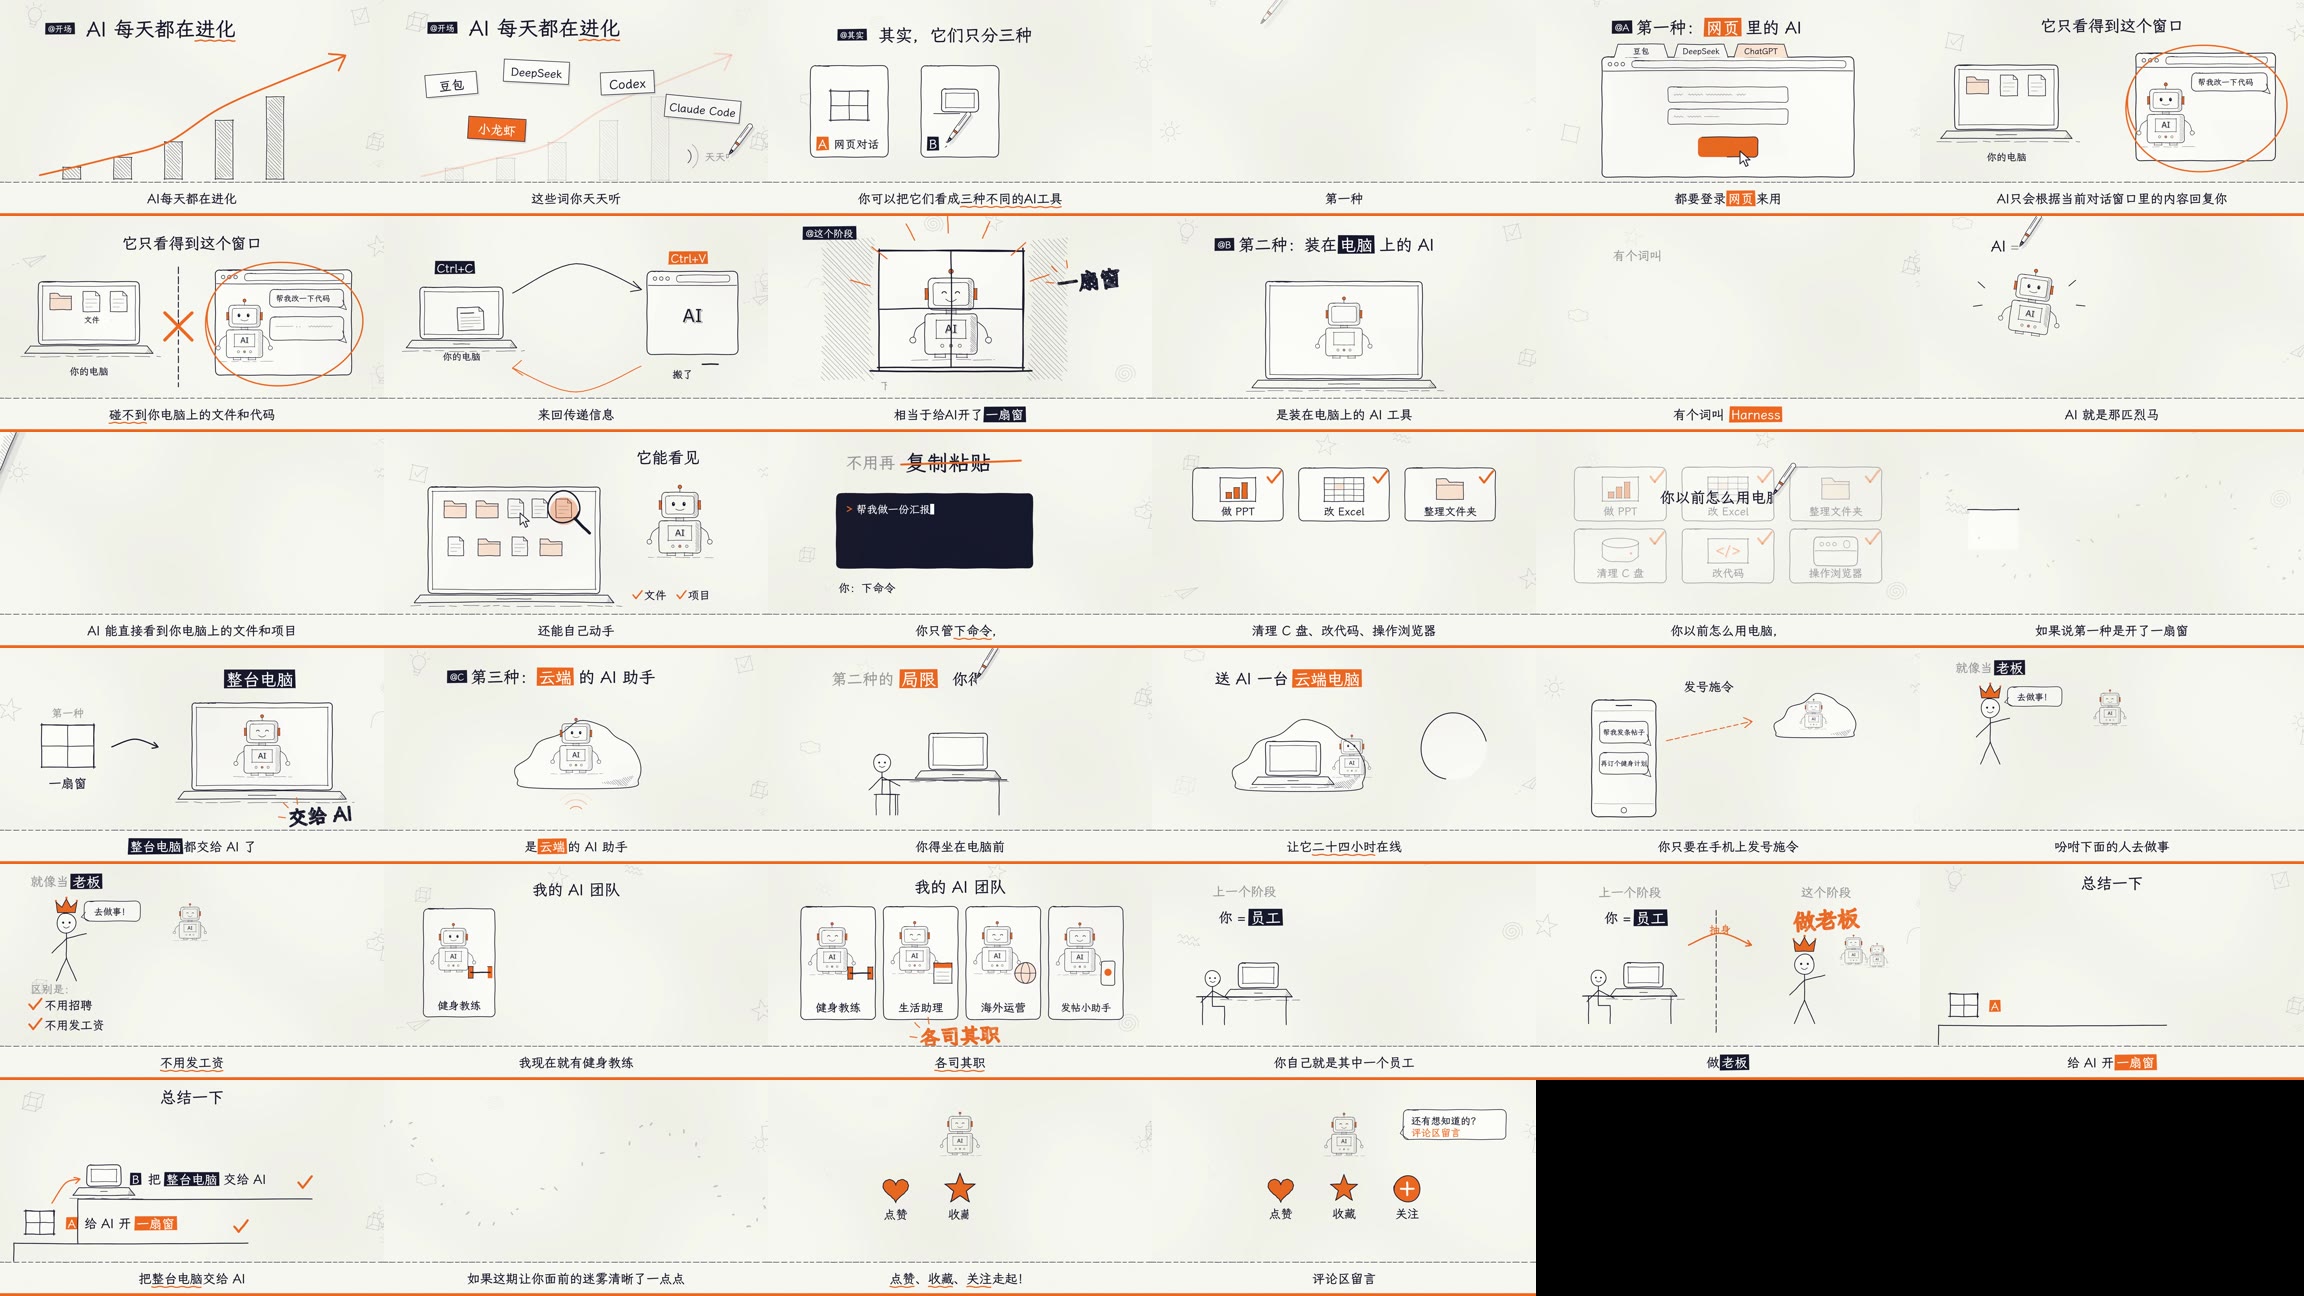
手绘白板
白纸、钢笔线、马克笔,边说边画。1920×1080(含竖屏补丁),Canvas 引擎,基于 dashi-animationstyle。适合抽象概念与方法论。
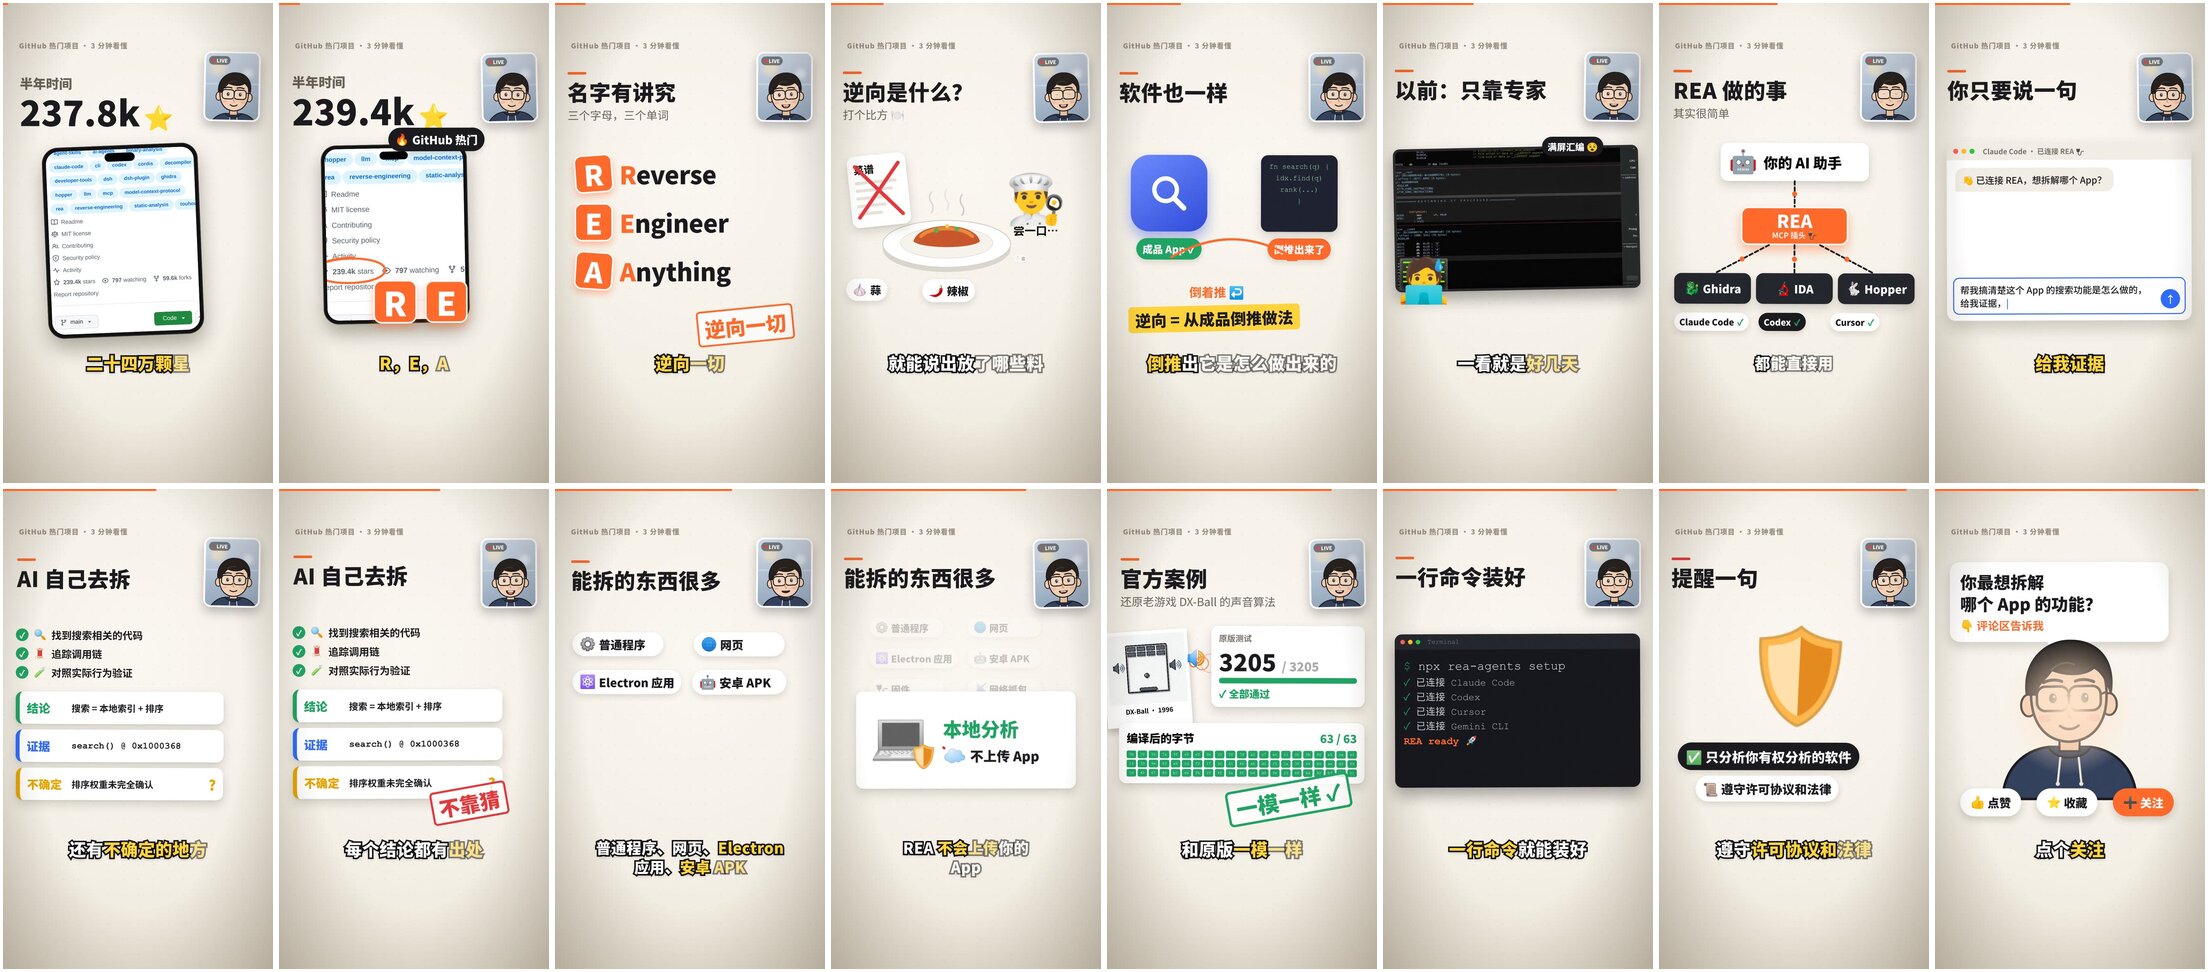
拟真竖屏出镜
带口型同步的出镜主播、真实截图装进设备外壳、橙色手绘圈注、手持微晃与胶片颗粒。1080×1920 原生竖屏,Remotion 模板含 13 个可复用场景。适合热点项目、产品介绍和带数据的新闻。
流程七步
- 选画风。Agent 会问,或按目标推荐。
- 研究 + 事实核查。数字、原话、截图先带出处和日期收集,再动笔。
- 写稿。
script.json,口语短句(每句 ≤20 字),3 秒内给钩子。 - 配音转逐字时间轴。真人录音走
voice_to_timeline.py,或高质量 TTS、edge-tts兜底;产出voice.wav+timeline.json。 - 画面。每个镜头只讲一个意思,元素出现时刻对齐到正在说的那个词。
- 质检。每个场景抽帧拼成联系表,按 9 项评分表打分,任一项低于 2/5 不交付。
- 配乐音效 + 混音。音效锚在「第 i 句的第 k 个词」,混音时音乐给人声让路,整体归一化到 −14 LUFS。
- 交付。成片 + 抖音 / 小红书 / B站(带章节时间戳)/ 视频号 / X 文案。
安装
复制整个文件夹——只拷 SKILL.md 不行,脚本和模板都在同级目录里。
# Claude Code / Codex
cp -r explainer-video ~/.claude/skills/     # 或 ~/.codex/skills/

# DeepSeek Harness
cp -r explainer-video ~/.dsh/skills/

# 环境检查(必须看到 ✓)
bash core/scripts/check_env.sh realistic    # 或 handdrawn
然后对 Agent 说:「用 explainer-video 做一条讲 <话题> 的竖屏视频。」
完整依赖清单与排错见 中文 README。
常见问题
explainer-video 是什么?
是一个可复用的 Agent Skill:一个含 SKILL.md 入口、共用制作流程、可运行的 Python/Shell 脚本和两套画风引擎的文件夹。AI 编码 Agent 加载它之后,就能从选题研究一路做到成片 MP4 和各平台文案。
支持哪些 Agent?
任何支持 skill 文件夹的 Agent,包括 Claude Code、Codex、DeepSeek Harness。参考成片是用 DeepSeek v4.1-flash 在 DeepSeek Harness 上跑出来的。
必须买 TTS 服务吗?
不必。edge-tts 免费且自带字级时间戳;付费 TTS(MiniMax、豆包/火山、ElevenLabs)或自己录,真人感更好。
真人录音自动对齐有多准?
本实例实测匹配率约 95%,中位误差约 0.04 秒(faster-whisper 词级对齐)。没装 faster-whisper 时会退化成静音切句 + 句内按字数均分。
换配音会不会打乱动画和音效?
不会。动画卡的是词,音效锚在 cues.json 里「第 i 句的第 k 个词」,重新配音会自动对齐,不用改代码。
画面是 AI 生成的吗?
不是。画面由真实代码渲染:拟真是 Remotion(React)合成,手绘是 Canvas 场景,输出确定、可审、可重渲,真实截图能像素级还原。
硬性依赖有哪些?
ffmpeg、Node 18+、Python 3 的 numpy,以及 Noto Sans SC、Noto Color Emoji、霞鹜文楷字体。拟真模板额外需要 Remotion 依赖;手绘风格需要 clone dashi-animationstyle。core/scripts/check_env.sh 会逐条报出缺什么。
免费吗?
MIT 许可,免费。但 Remotion 商用需遵守它自己的条款,字体和 dashi-animationstyle 也各自遵循原许可。